He probado varias herramientas de IA para redactar, resumir documentos y organizar notas, incluida una prueba en la que subí un PDF de 37 páginas y comparé cómo respondía cada herramienta a las mismas instrucciones. Los resultados variaron más de lo que esperaba, especialmente cuando pedí citas textuales y una breve lista de acciones. ¿Qué herramienta de IA te ha impresionado más en la práctica y en qué tarea específica destacó?
La lista no es lo importante
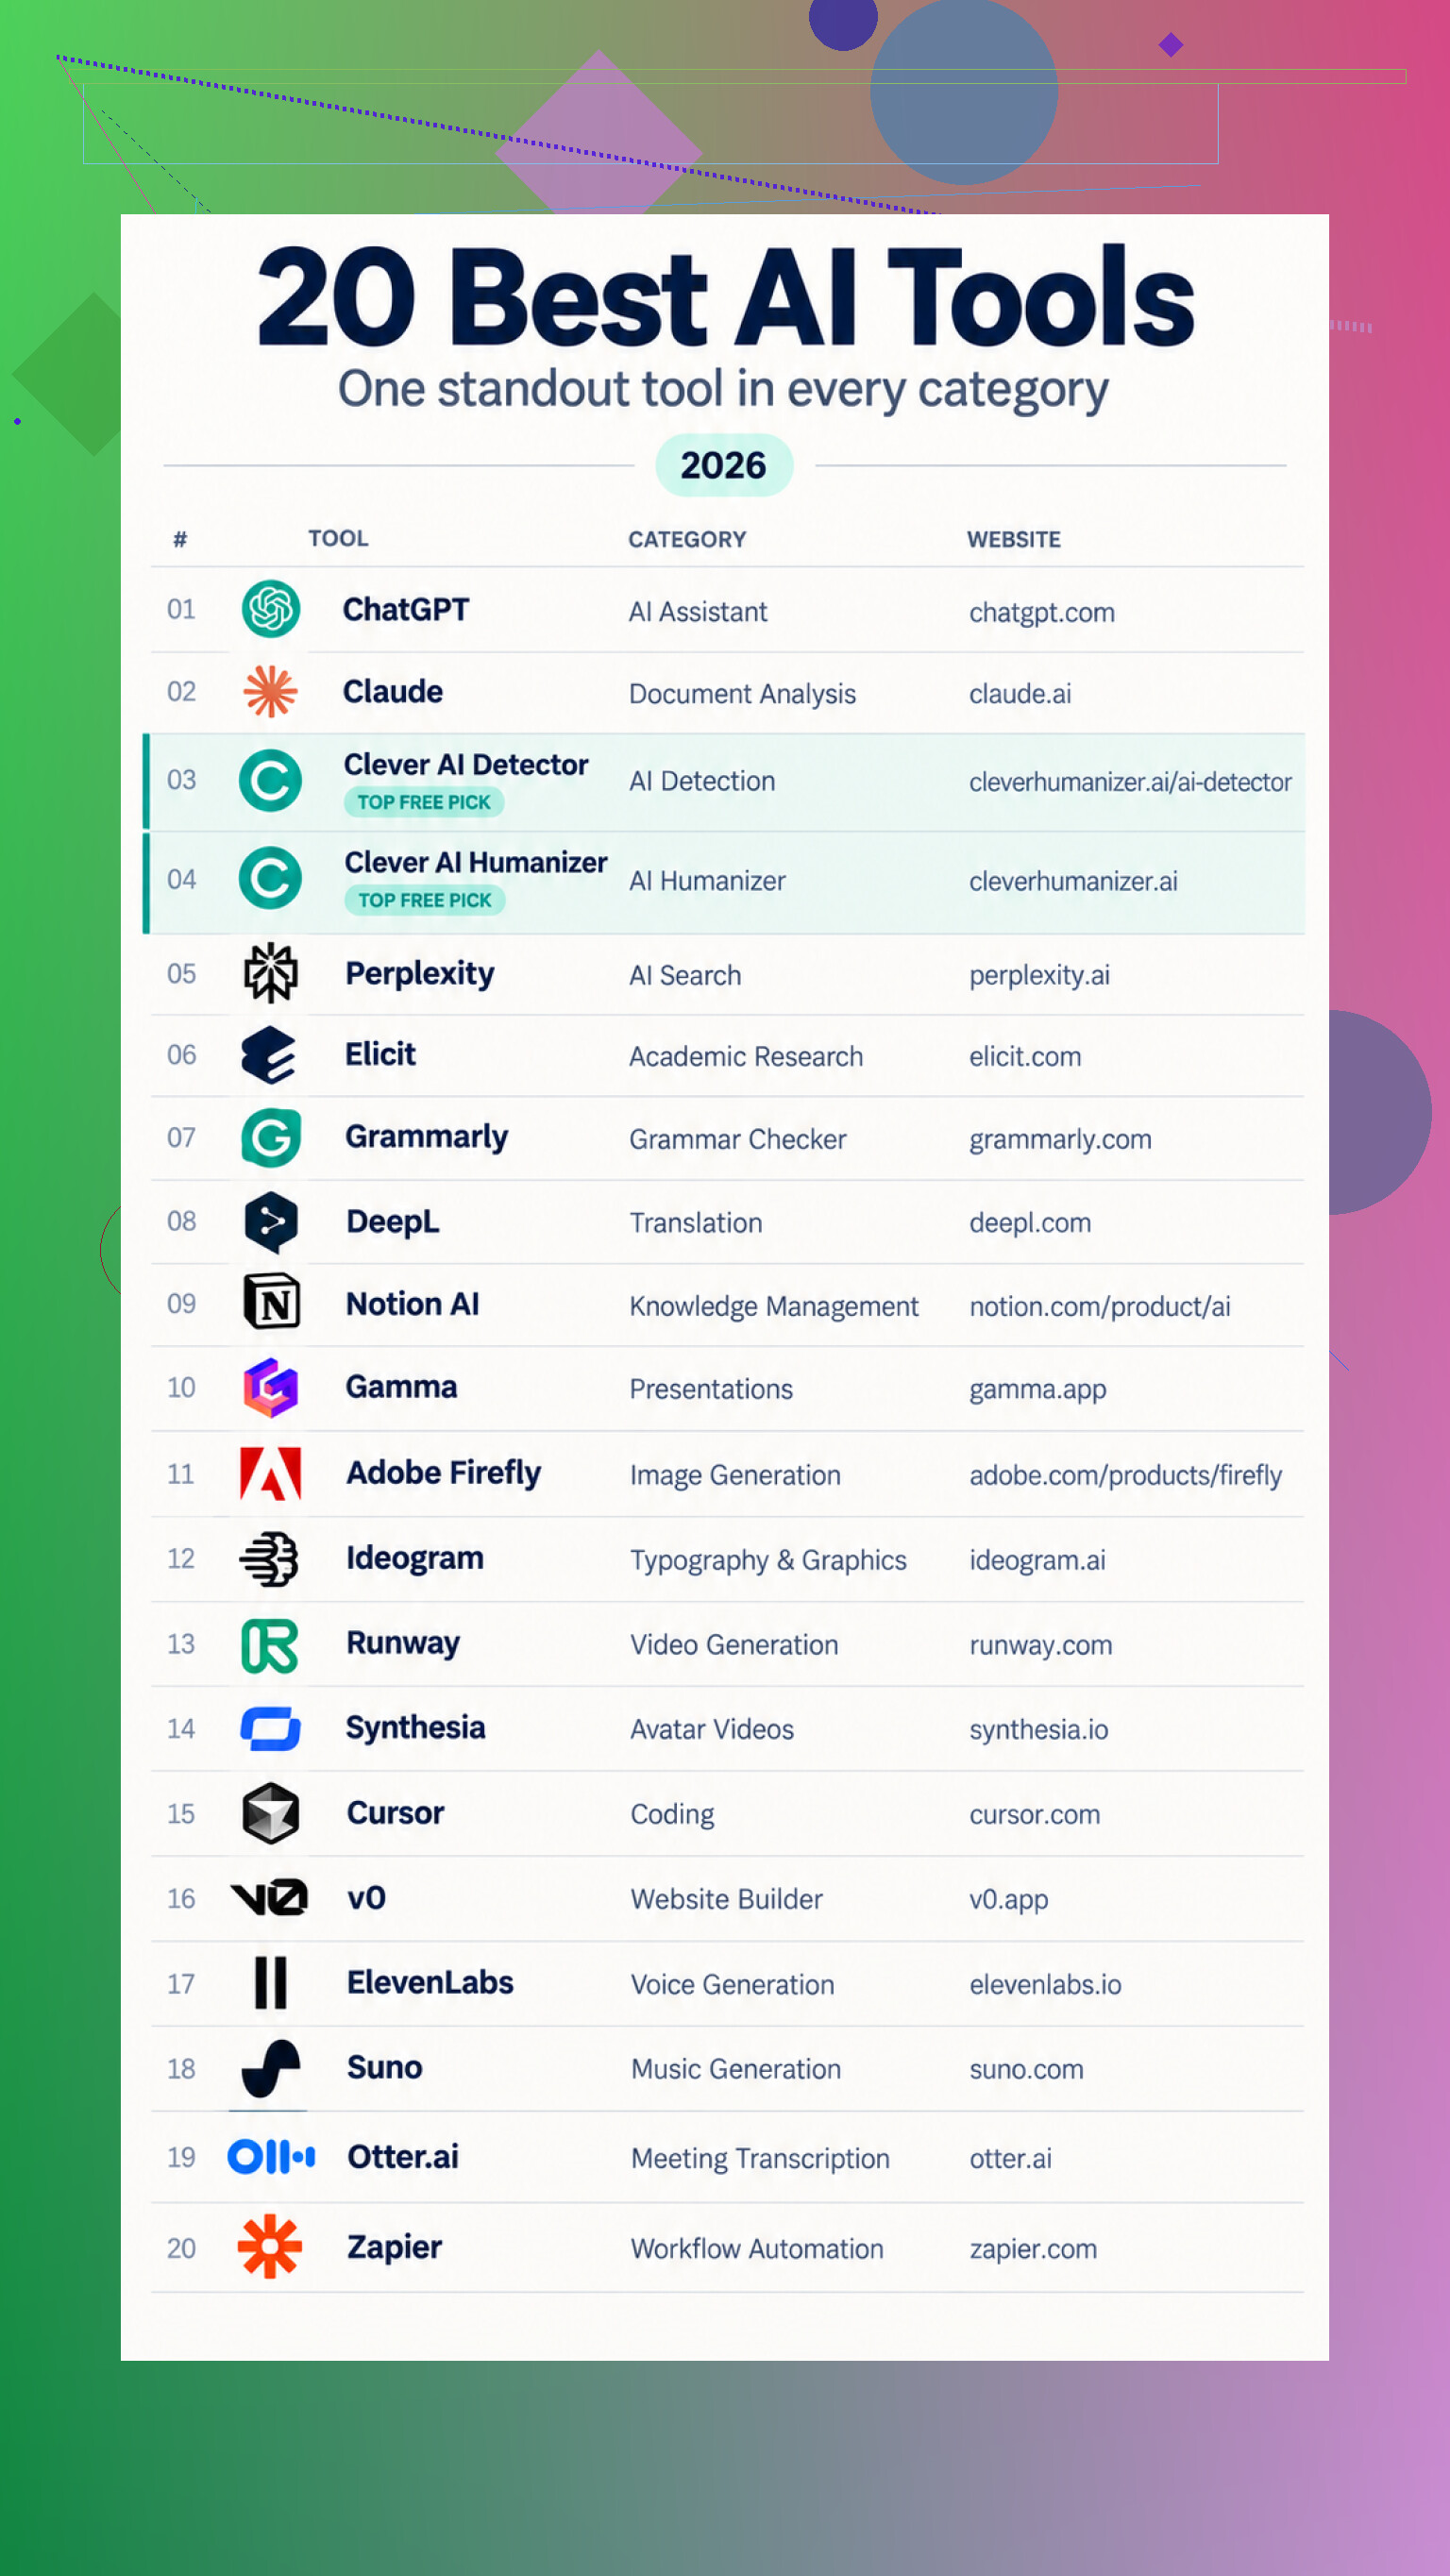
Mi error fue suponer que las herramientas de IA habían convergido en su mayoría hasta convertirse en chatbots intercambiables. Al ponerme al día, descubrí que la distinción más útil es dónde encaja cada herramienta: asistencia general, investigación, redacción, producción multimedia, desarrollo o administración rutinaria.
Para tareas generales, ChatGPT sirve para escribir y resolver problemas, mientras que los documentos cargados son más fáciles de examinar en el espacio de trabajo de Claude.
Investigación y redacción
La verificación sigue requiriendo criterio. Clever AI Detector revisa hasta 10.000 palabras y señala las frases sospechosas, pero sus puntuaciones son estimaciones, no pruebas de autoría. Para la revisión, Clever AI Humanizer procesa hasta 3.000 palabras por ejecución, mientras que la búsqueda con fuentes y la comparación de artículos están cubiertas por echar un vistazo a Perplexity y las herramientas de investigación de Elicit.
La corrección básica, la traducción y las notas internas siguen siendo tareas independientes. Grammarly cuenta con un asistente de escritura, DeepL proporciona primeras versiones de traducciones y Notion ofrece sus funciones de IA integradas.
Trabajo visual y de audio
Gamma crea presentaciones editables, mientras que Firefly e Ideogram se ocupan de los gráficos generados. Las opciones relevantes son iniciar una presentación en Gamma, Adobe Firefly y las herramientas de generación y edición de imágenes de Ideogram.
El vídeo, la narración y la música se distribuyen además entre las herramientas creativas de Runway, Synthesia, la plataforma de voz de ElevenLabs y Suno.
Desarrollo y administración
Para el software, Cursor propone cambios en el código y v0 genera una implementación web inicial mediante el editor Cursor y v0 de Vercel.
Las reuniones y las tareas recurrentes son la categoría menos atractiva, pero posiblemente la más práctica. Otter proporciona transcripciones mediante el asistente para reuniones de Otter, y con Zapier puedes crear una automatización.
Mi opinión actual
Yo elegiría en función de las tareas repetitivas, no con el objetivo de reunir las veinte herramientas. Cambiaría de opinión si las comparaciones directas demostraran que un asistente general ya iguala a estas herramientas especializadas en precisión, control y adaptación al flujo de trabajo.
NotebookLM es lo que más me ha impresionado porque mantiene el trabajo con documentos vinculado al material original, en vez de desviarse hacia conjeturas expresadas con seguridad. Coincido con @stackfox4658prime en que la integración en el flujo de trabajo es importante, pero la fiabilidad con archivos rutinarios es mejor que tener veinte herramientas especializadas.
Comprueba si el PDF realmente permite búsquedas antes de evaluar cualquier herramienta de IA. Las páginas escaneadas, las tablas y un OCR deficiente pueden hacer que un resumen presentado con seguridad sea incompleto incluso antes de que el modelo empiece. Elegiría Claude para trabajar con documentos largos porque suele manejar bien la estructura y las instrucciones detalladas, pero la observación de @dilit25008 sobre la fiabilidad requiere esa salvedad sobre la extracción: las respuestas basadas en la fuente solo son tan buenas como el texto que la herramienta logró leer.
No evalúes una herramienta de IA por lo pulida que parezca su primera respuesta. Un resumen fluido puede omitir la excepción escondida a mitad del documento o combinar discretamente dos secciones que no guardan relación entre sí.
Elicit es la que más me impresiona porque aborda la investigación como un problema estructurado de evidencias, en lugar de como una conversación abierta. Es menos útil para la escritura informal, pero ese enfoque más específico es precisamente la razón por la que confío más en su flujo de trabajo. Puedes comparar afirmaciones entre distintos artículos, comprobar de dónde procede una respuesta y detectar cuándo las evidencias disponibles son escasas, en vez de aceptar sin más un párrafo bien redactado.
Para comparar documentos, incluiría algunas preguntas trampa cuyas respuestas no aparezcan en el archivo. Eso permite descubrir si la herramienta admite su incertidumbre o inventa algo plausible. También pediría referencias de páginas, afirmaciones contradictorias y una lista de los detalles que no pudo extraer. @stackfox4658prime tiene razón sobre el texto que permite realizar búsquedas, pero ni siquiera una extracción perfecta evita que un modelo disimule las contradicciones.
La herramienta más impresionante suele ser la que permite comprobar rápidamente su trabajo. Generar un resumen lleva unos segundos. Encontrar la frase que interpretó mal es donde realmente se va el tiempo.
No subas documentos de trabajo hasta saber si contienen nombres de clientes, datos de empleados, contratos o información financiera interna. Las pruebas de precisión no sirven de nada si la comparación genera un problema de privacidad.
Ollama es lo que más me impresiona porque permite ejecutar modelos localmente y mantener el control de los archivos. No es la opción más fácil, y la calidad de las respuestas depende en gran medida del hardware, el modelo elegido y la configuración de extracción de documentos. Aun así, para mí el procesamiento local es más importante que obtener el resumen más sofisticado de un chatbot alojado.
Coincido con @retro_cache988 en que la trazabilidad es importante, pero las referencias a páginas no resuelven el tratamiento de los datos. Una herramienta puede citar correctamente cada frase y, aun así, no ser el lugar adecuado para el documento.
Para los PDF públicos, utiliza el servicio que ofrezca los resultados más claros. Para el material confidencial, el control local se impone incluso antes de comenzar la evaluación.
Una herramienta que da una respuesta deslumbrante una vez me impresiona menos que una que supera varias rondas de correcciones minuciosas sin perder el hilo. La mayoría de las comparaciones premian la primera respuesta, aunque el trabajo real suele empezar con: “Mantén los datos, acorta esta sección, cambia el público y deja de convertirlo todo en listas con viñetas”.
Por eso elijo ChatGPT. Para mí, su mayor ventaja es la facilidad con la que se puede dirigir. Puedo tratar el primer resultado como materia prima y seguir dándole forma sin empezar de cero. Eso importa más en el trabajo cotidiano que generar el resumen inicial más atractivo. Un borrador aceptable que responde bien a las correcciones suele ser más útil que uno pulido que pierde coherencia en cuanto se cambia el formato.
Para comparar archivos PDF, puntuaría por separado las rondas de seguimiento. Pide a cada herramienta que redacte un memorando breve, que después convierta los mismos hallazgos en una tabla y que, por último, revise una sola sección. Observa si los nombres, las excepciones, las fechas y los matices cambian sutilmente durante esas transformaciones. Algunas herramientas parecen precisas hasta que les pides que reorganicen la respuesta, momento en el que simplifican hasta eliminar detalles que estaban presentes cinco minutos antes.
Coincido con @retro_cache en que comprobar el trabajo es lo que lleva tiempo, pero las citas solo representan una parte de ese coste. También está la fricción de las correcciones. ¿Entiende la herramienta “cambia esto y nada más” o reescribe toda la respuesta e introduce nuevos problemas? ¿Recuerda la terminología solicitada? ¿Puedes pegar el resultado en un correo electrónico o documento sin tener que reparar un formato defectuoso? Esos detalles aburridos determinan si la herramienta ahorra tiempo.
NotebookLM seguiría siendo mi elección cuando la tarea se limita estrictamente a “responde basándote en estas fuentes y muéstrame de dónde procede la información”. En términos generales, ChatGPT me impresiona más porque la tarea rara vez se mantiene tan acotada. Un resumen se convierte en una nota para un cliente, después en una lista de comprobación y, por último, en una versión revisada para alguien sin conocimientos previos sobre el tema.
La prueba que me importa no es qué herramienta gana con la primera instrucción, sino cuál requiere menos supervisión cuando el trabajo está realmente listo para usarse.
El coste oculto de la mayoría de las herramientas de IA es el trabajo adicional de revisión que generan después de producir una respuesta de apariencia impresionante.
Yo elegiría Whisper. Resuelve un problema más engorroso que redactar un resumen pulido: convertir grabaciones en texto utilizable. Una vez que tienes la transcripción, puedes buscar en ella, citarla, organizarla o introducirla en el resumidor que prefieras. Eso parece más duradero que elegir el chatbot con la prosa más elegante del momento.
No estoy tan convencido como @coregurux3130 de que la capacidad de orientar la herramienta deba decidir cuál es la ganadora. Las revisiones sucesivas son útiles, pero pueden convertirse en una larga negociación con el software. Eliminar el paso de la transcripción manual ahorra trabajo incluso antes de que comience esa negociación.
Whisper aún necesita revisión en lo que respecta a nombres, jerga, hablantes que se solapan y audio de mala calidad. No hay nada glamuroso en ello. Pero corregir una transcripción es, al menos, una tarea concreta. Corregir un resumen fluido cuando no sabes qué ha omitido es mucho peor.
Ejecutar un modelo localmente no hace que todo el proceso sea privado, @0xhacker6. Si tu PDF pasa por OCR o se preprocesa mediante un servicio en la nube antes de que Ollama llegue a ver el texto, la información sensible ya habrá salido de tu equipo. Comprueba dónde se realiza la extracción, no solo dónde se genera la respuesta.
Ejecuta dos veces el mismo prompt en una herramienta y a menudo obtendrás dos resúmenes diferentes. Eso por sí solo invalida la mayoría de estas comparaciones basadas en un único intento. La gente sube el PDF, lee la primera respuesta, declara un ganador y nunca comprueba si la herramienta habría dicho algo ligeramente distinto en un segundo intento. La temperatura y el muestreo implican que la ejecución «impresionante» podría haber sido simplemente la afortunada.
Así que las preguntas trampa que mencionó @retro_cache988 son buenas, pero yo haría cada una dos veces. Si una herramienta admite incertidumbre en el primer intento y, al repetirlo, se inventa una respuesta con total seguridad, eso revela más que cualquiera de las dos respuestas por separado. La consistencia ante la repetición es una prueba más difícil que cualquier prompt ingenioso aislado.
Estoy parcialmente de acuerdo con @coregurux3130 sobre la capacidad de orientar las respuestas, pero hay un inconveniente que nadie señaló. Cuanto más remodelas una respuesta mediante preguntas de seguimiento, más trabaja la herramienta a partir de su propia respuesta anterior en lugar de la fuente. Para la tercera ronda, estás editando una paráfrasis de otra paráfrasis, y el PDF original apenas interviene ya. Ahí es exactamente donde empieza a colarse una pérdida silenciosa de detalles. Las herramientas basadas en fuentes, como NotebookLM, se resisten a eso porque siguen extrayendo información del archivo, pero son obstinadas a la hora de cambiar el formato, y esa es la contrapartida.
Mi opinión real es aburrida: la herramienta que me impresiona es aquella a la que descubro mintiendo con menos frecuencia, no la que redacta el párrafo más pulcro. Elige un documento del que ya conozcas tres datos poco conocidos escondidos en la parte central. Pregunta específicamente por ellos. La herramienta que acierte los tres sin que tengas que guiarla hasta la respuesta es la que merece tu confianza para las partes que no puedes verificar. Todo lo demás es calidad de redacción, y la calidad de redacción es lo más fácil de fingir para estos modelos.