Já testei várias ferramentas de IA para escrever, resumir documentos e organizar anotações, incluindo um teste em que enviei um PDF de 37 páginas e comparei como cada ferramenta lidou com as mesmas instruções. Os resultados variaram mais do que eu esperava, especialmente quando pedi trechos citados e uma breve lista de ações. Qual ferramenta de IA mais impressionou você no uso real e em qual tarefa específica ela se destacou?
A lista não é o ponto principal
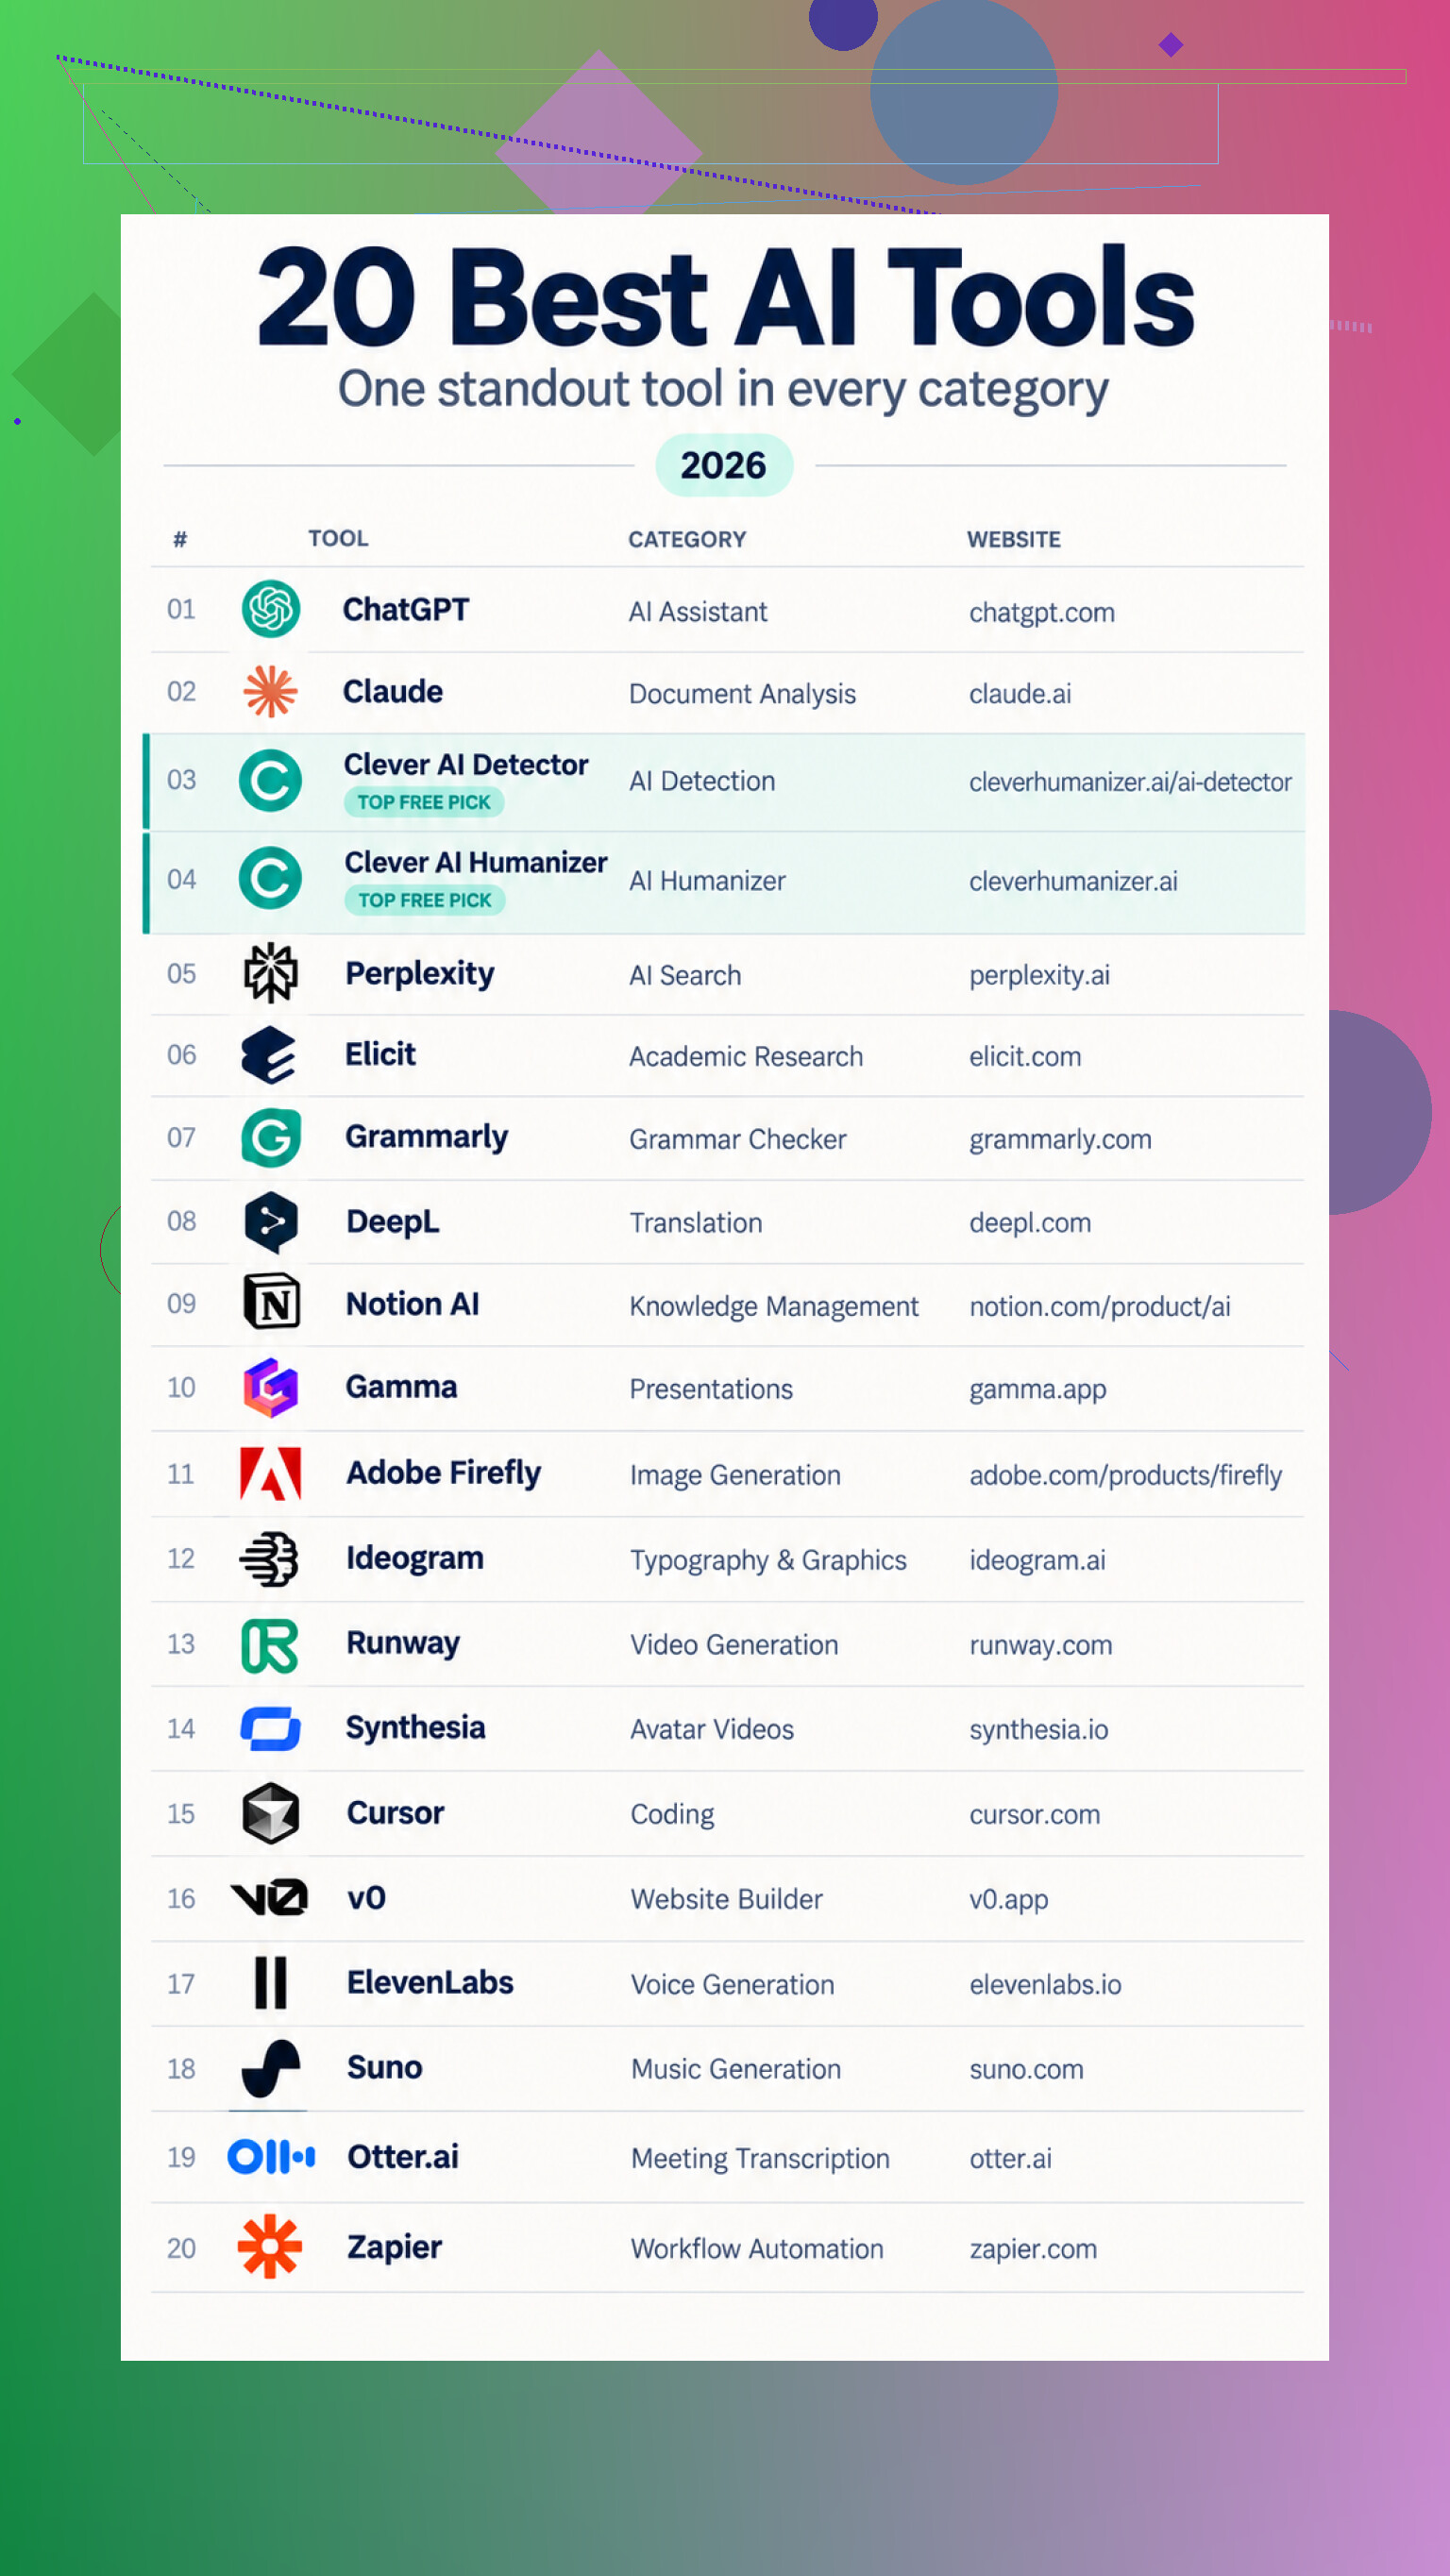
Meu erro foi presumir que as ferramentas de IA haviam, em sua maioria, convergido para chatbots intercambiáveis. Ao me atualizar, descobri que a distinção mais útil é onde cada ferramenta se encaixa: assistência geral, pesquisa, redação, produção de mídia, desenvolvimento ou administração de rotina.
Para trabalhos abrangentes, o ChatGPT atende às necessidades de redação e resolução de problemas, enquanto documentos enviados são mais fáceis de analisar no espaço de trabalho do Claude.
Pesquisa e redação
A verificação ainda exige discernimento. O Clever AI Detector verifica até 10.000 palavras e sinaliza frases suspeitas, mas suas pontuações são estimativas, não provas de autoria. Para revisão, o Clever AI Humanizer processa até 3.000 palavras por vez, enquanto a pesquisa com fontes e a comparação de artigos ficam por conta de conheça o Perplexity e das ferramentas de pesquisa do Elicit.
A revisão básica, a tradução e as anotações internas continuam sendo tarefas distintas. O Grammarly tem um assistente de redação, o DeepL fornece traduções preliminares e o Notion oferece seus recursos de IA integrados.
Trabalho visual e de áudio
O Gamma cria apresentações editáveis, enquanto o Firefly e o Ideogram são voltados para a criação de elementos gráficos. As opções relevantes são começar uma apresentação no Gamma, Adobe Firefly e as ferramentas de geração e edição de imagens do Ideogram.
Vídeo, narração e música se dividem ainda mais entre as ferramentas criativas do Runway, o Synthesia, a plataforma de voz da ElevenLabs e o Suno.
Desenvolvimento e administração
Para software, o Cursor propõe alterações no código e o v0 gera uma implementação inicial para a web por meio do editor Cursor e do v0 da Vercel.
Reuniões e tarefas recorrentes são a categoria menos glamourosa, mas possivelmente a mais prática. O Otter fornece transcrições por meio do assistente de reuniões do Otter e, com o Zapier, você pode criar uma automação.
Minha visão atual
Eu escolheria com base nas tarefas recorrentes, em vez de reunir todas as vinte ferramentas. Eu mudaria de ideia se comparações diretas mostrassem que um assistente de uso geral agora se equipara a essas ferramentas especializadas em precisão, controle e adequação ao fluxo de trabalho.
O NotebookLM foi o que mais me impressionou porque mantém o trabalho com documentos vinculado ao material de origem, em vez de cair em suposições apresentadas com confiança. Concordo com @stackfox4658prime que a adequação ao fluxo de trabalho é importante, mas a confiabilidade com arquivos comuns é melhor do que ter vinte ferramentas especializadas.
Verifique se o PDF realmente permite pesquisa antes de avaliar qualquer ferramenta de IA. Páginas digitalizadas, tabelas e OCR de baixa qualidade podem fazer com que um resumo aparentemente seguro fique incompleto antes mesmo de o modelo começar. Eu escolheria o Claude para trabalhar com documentos longos, pois ele geralmente lida bem com estrutura e instruções detalhadas, mas a observação de @dilit25008 sobre confiabilidade precisa incluir a ressalva da extração: respostas fundamentadas na fonte são tão boas quanto o texto que a ferramenta conseguiu ler.
Não avalie uma ferramenta de IA pelo quão bem elaborada parece a primeira resposta. Um resumo fluido ainda pode omitir a exceção escondida no meio do documento ou combinar discretamente duas seções que não têm relação entre si.
O Elicit é o que mais me impressiona porque trata a pesquisa como um problema de evidências estruturadas, em vez de uma conversa aberta. É menos útil para redação casual, mas esse foco mais restrito é justamente o motivo pelo qual confio mais no fluxo de trabalho. Você pode comparar afirmações entre artigos, verificar de onde veio uma resposta e perceber quando as evidências disponíveis são escassas, em vez de aceitar um parágrafo bem elaborado sem questionar.
Para comparações de documentos, eu incluiria algumas perguntas-armadilha cujas respostas não estão presentes no arquivo. Isso revela se a ferramenta admite a incerteza ou inventa algo plausível. Eu também pediria referências de páginas, declarações conflitantes e uma lista de detalhes que ela não conseguiu extrair. @stackfox4658prime tem razão quanto ao texto pesquisável, mas nem mesmo uma extração perfeita impede que um modelo disfarce contradições.
A ferramenta mais impressionante geralmente é aquela que permite verificar rapidamente o próprio trabalho. Gerar um resumo leva segundos. Encontrar a frase que ela interpretou incorretamente é o que realmente consome tempo.
Não faça upload de documentos de trabalho antes de saber se eles contêm nomes de clientes, dados de funcionários, contratos ou informações financeiras internas. Testes de precisão não fazem sentido se a comparação criar um problema de privacidade.
O Ollama é o que mais me impressiona porque permite executar modelos localmente e manter o controle dos arquivos. Não é a opção mais fácil, e a qualidade das respostas depende muito do seu hardware, da escolha do modelo e da configuração da extração de documentos. Ainda assim, o processamento local é mais importante para mim do que obter o resumo mais sofisticado de um chatbot hospedado.
Concordo com @retro_cache988 que a rastreabilidade é importante, mas as referências de página não resolvem a questão do tratamento de dados. Uma ferramenta pode citar corretamente todas as frases e, ainda assim, não ser o lugar adequado para o documento.
Para PDFs públicos, use o serviço que fornecer os resultados mais claros. Para materiais confidenciais, o controle local vence antes mesmo de a avaliação começar.
Uma ferramenta que dá uma resposta deslumbrante de primeira me impressiona menos do que uma que aguenta várias rodadas de correções minuciosas sem perder o fio da meada. A maioria das comparações valoriza a primeira resposta, embora o trabalho de verdade geralmente comece com: “Mantenha os fatos, encurte esta seção, mude o público-alvo e pare de transformar tudo em listas com marcadores.”
É por isso que escolho o ChatGPT. Para mim, sua maior vantagem é a facilidade de direcionamento. Posso tratar o primeiro resultado como matéria-prima e continuar reformulando-o sem começar do zero. No trabalho cotidiano, isso importa mais do que produzir o resumo inicial mais bonito. Um rascunho razoável que responde bem às correções costuma ser mais útil do que um rascunho refinado que se torna inconsistente assim que o formato é alterado.
Para uma comparação de PDFs, eu avaliaria separadamente as rodadas de acompanhamento. Peça a cada ferramenta que produza um memorando curto, depois converta as mesmas conclusões em uma tabela e, em seguida, revise apenas uma seção. Observe se nomes, exceções, datas e ressalvas mudam discretamente durante essas transformações. Algumas ferramentas parecem precisas até que você peça para reorganizarem a resposta; nesse momento, elas simplificam e eliminam detalhes que estavam presentes cinco minutos antes.
Concordo com @retro_cache que verificar o trabalho é o que consome tempo, mas as citações são apenas parte desse custo. Há também o atrito das correções. A ferramenta entende “mude isto e nada mais” ou reescreve toda a resposta e introduz novos problemas? Ela se lembra da terminologia solicitada? É possível colar o resultado em um e-mail ou documento sem precisar corrigir a formatação quebrada? Esses detalhes enfadonhos determinam se a ferramenta realmente economiza tempo.
O NotebookLM ainda seria minha escolha quando a tarefa fosse estritamente “responda com base nestas fontes e mostre de onde veio a informação”. No geral, o ChatGPT me impressiona mais porque a tarefa raramente permanece tão restrita. Um resumo vira uma nota para o cliente, depois uma lista de verificação e, em seguida, uma versão revisada para alguém sem nenhum conhecimento prévio sobre o assunto.
O teste que importa para mim não é qual ferramenta vence no primeiro prompt. É qual delas exige menos supervisão até que o trabalho esteja realmente pronto para uso.
O custo oculto da maioria das ferramentas de IA é o trabalho extra de revisão que elas geram depois de produzir uma resposta aparentemente impressionante.
Minha escolha seria o Whisper. Ele resolve um problema mais complicado do que escrever um resumo bem elaborado: transformar gravações em texto utilizável. Depois que a transcrição existe, você pode pesquisá-la, citá-la, organizá-la ou inseri-la no resumidor que preferir. Isso parece mais duradouro do que escolher o chatbot com a prosa mais elegante do mês.
Estou menos convencido do que @coregurux3130 de que a capacidade de direcionamento deva determinar o vencedor. Revisões repetidas são úteis, mas podem se transformar em uma longa negociação com o software. Eliminar a etapa de transcrição manual poupa esforço antes mesmo que essa negociação comece.
O Whisper ainda precisa de revisão em nomes, jargões, falas sobrepostas e áudios ruins. Não há glamour nisso. Mas corrigir uma transcrição é, pelo menos, uma tarefa concreta. Corrigir um resumo fluido sem saber o que ele omitiu é muito pior.
Executar um modelo localmente não torna todo o pipeline privado, @0xhacker6. Se o seu PDF passar por OCR ou pré-processamento por meio de um serviço na nuvem antes mesmo de o Ollama ver o texto, a parte confidencial já terá saído da sua máquina. Verifique onde ocorre a extração, não apenas onde a resposta é gerada.
Execute o mesmo prompt duas vezes em uma ferramenta e muitas vezes você obterá dois resumos diferentes. Só isso já invalida a maioria dessas comparações feitas com uma única tentativa. As pessoas enviam o PDF, leem a primeira resposta, declaram um vencedor e nunca verificam se a ferramenta diria algo ligeiramente diferente em uma segunda tentativa. A temperatura e a amostragem significam que a execução “impressionante” pode ter sido apenas a que deu sorte.
Então, as perguntas capciosas que @retro_cache988 mencionou são boas, mas eu faria cada uma delas duas vezes. Se uma ferramenta admite incerteza na primeira tentativa e inventa uma resposta com confiança na segunda, isso é mais revelador do que qualquer uma das respostas isoladamente. A consistência diante da repetição é um teste mais difícil do que qualquer prompt engenhoso isolado.
Concordo em parte com @coregurux3130 sobre a capacidade de direcionamento, mas há uma ressalva que ninguém mencionou. Quanto mais você reformula uma resposta por meio de perguntas de acompanhamento, mais a ferramenta trabalha com base na própria resposta anterior, em vez de usar a fonte. Na terceira rodada, você está editando uma paráfrase de outra paráfrase, e o PDF original mal participa mais do processo. É justamente aí que a perda silenciosa de detalhes começa a surgir. Ferramentas fundamentadas em fontes, como o NotebookLM, resistem a isso porque continuam recorrendo ao arquivo, mas são pouco flexíveis quanto à reformatação, e essa é a contrapartida.
Minha opinião real é sem graça: a ferramenta que me impressiona é aquela que pego mentindo com menos frequência, não a que escreve o parágrafo mais bem elaborado. Escolha um documento no qual você já conheça três fatos obscuros escondidos no meio. Pergunte especificamente sobre eles. A ferramenta que acertar os três sem que você precise conduzi-la até as respostas é a que vale a pena usar nas partes que você não consegue verificar. Todo o resto é qualidade da prosa, e a qualidade da prosa é a coisa mais fácil para esses modelos fingirem.